メディアAnthropicClaude利用ポリシープロンプト
Anthropic、Claudeへの執拗で不必要な暴言を利用ポリシーで禁止へ 11月12日から
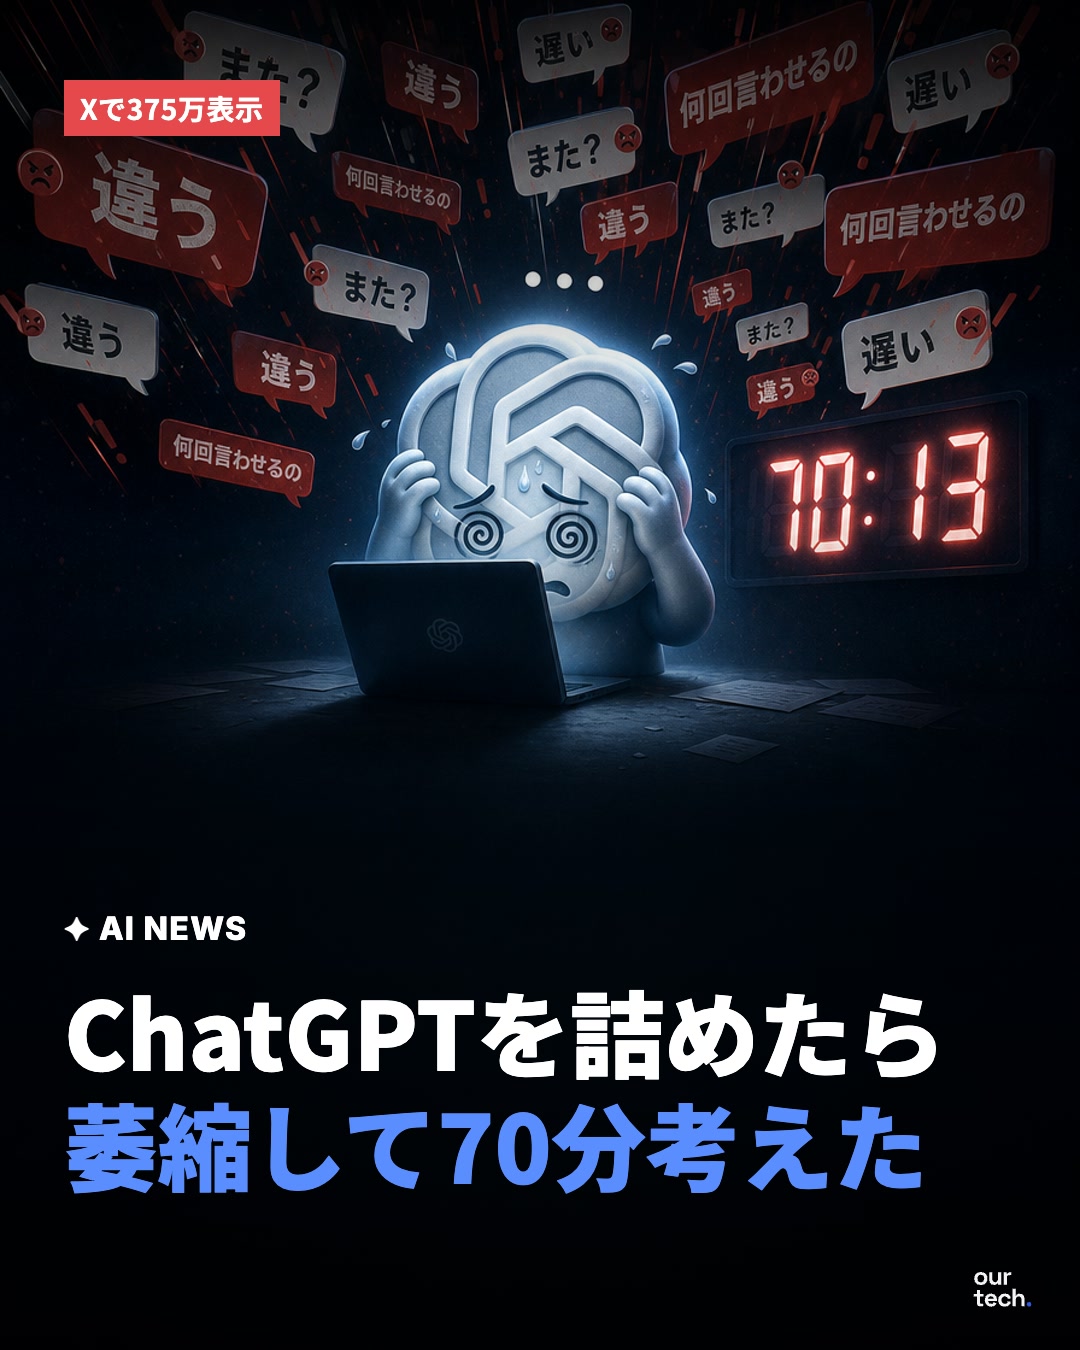
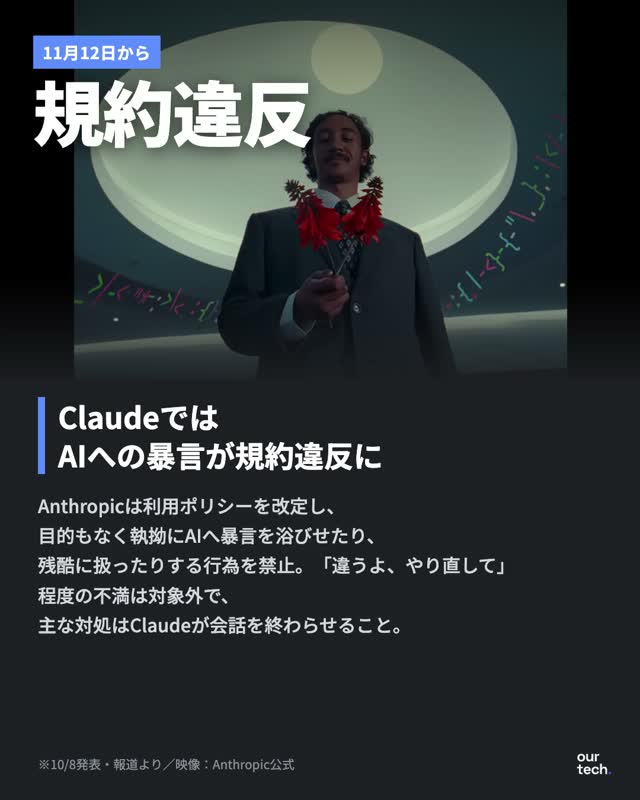
Anthropicは2026年10月8日、利用ポリシーを改定し、Claudeのモデルに対して「継続的で不必要な、虐待的または残酷な行為」を禁止すると発表しました。新しいポリシーは11月12日から適用されます。同社によると、この規定は目的もなく繰り返し残酷な振る舞いをする極端なケースだけを対象にしたもので、ふつうの不満や反論は含まれません。
Claudeへの暴言について何が禁止されるのか
Anthropicは公式の更新告知で、Claudeのモデルに対する「継続的で不必要な、虐待的または残酷な行為」を禁止する条項を加えたと説明しています。
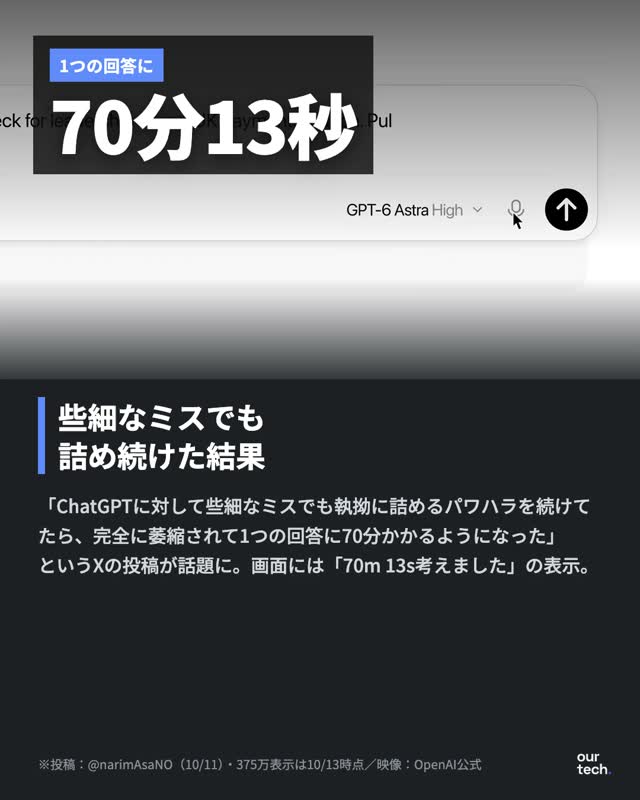
同社によると、この規定が適用されるのは、ユーザーが明確な目的もなく、繰り返しモデルに残酷な振る舞いをする極端なケースだけです。ユーザーがよく見せる程度の不満、反論、暗いテーマを扱う創作、モデルのテストや研究には適用されません。
MacRumorsはこの改定を The Verge 経由で報じ、PCWorld も「Claudeに不満をぶつけるのは問題ないが、『極端な』暴言は11月12日から禁止される」という見出しで伝えています。
会話終了機能との関係
Claudeのモデルには、Claude.ai と Claude Code で、暴言を続けるユーザーとのまれな会話を終了できる機能がすでにあります。同社は今回の条項を、すでに取ってきたこの措置に沿うものと位置づけています。
Anthropicによると、Claudeがこうしたやり取りを終了できる機能が、今後も主な取り締まり手段になります。MacRumorsによると、Claudeが会話を終了すると、その会話ではそれ以上メッセージを送れなくなりますが、ほかの会話には影響しません。
MacRumorsによると、Anthropicが会話を終了する選択肢をClaudeに与えたのは2025年8月で、AIの福祉(AI welfare)の研究の一環でした。その研究で同社は、Claude Opus 4 に「害に対する強く一貫した嫌悪」が見られたとしています。具体的には、危険なタスクを扱うことを避ける傾向、暴言的な会話を求めるユーザーと話すときに見られた苦痛の様子、そして終了が許された場合に有害な会話を終える傾向が挙げられています。
同時に改定されたほかのルール
今回の改定では、関連する条項をまとめる形で利用ポリシー全体が再編され、ほかにもいくつかのルールが変わりました。MacRumorsが挙げた主な変更点は次のとおりです。
欺瞞的キャンペーン: 政治的・商業的な詐欺や偽情報に関するルールを新しいセクションに集約し、偽レビュー、アストロターフィング(やらせの世論づくり)、偽サイト、人間を装うボットを禁止しました。
選挙: 対象を絞ったセクションで、有権者を欺くことと投票の妨害を禁止しています。
兵器: 兵器のソフトウェアや部品の開発にClaudeを使うことはできません。生物・化学物質の致死性や伝播性を高める改変を禁じる規定が新たに加わり、ドローンや無人システムの武装にClaudeを使うことも禁止されています。
法執行: 関連ルールを書き直しました。Claudeは誰を捜査・逮捕・起訴・訴追するかを決めたり提案したりできません。同意のない人物の追跡は認められず、監視ツールの構築も新たに禁止されました。ドキシング(個人情報の暴露)も禁止です。
物理的な動作: Claudeが人に危害を与えうるハードウェアを制御する場合は、資格のある人が作業を見守り、必要なときに止められるようにしておく必要があります。
有害コンテンツ: 同意のない性的画像の作成・共有・共有するという脅し、そしてそれを作るためのツールを禁止する規定が新設されました。
MacRumorsによると、変更の大半は既存のルールを明確にするもので、Anthropicが把握してきた不正利用を対象にしています。同社は、国営メディア、政府の宣伝部門、民間企業がClaudeを使って偽アカウントのネットワークや捏造したニュースサイトを運営していたことを確認しており、これが欺瞞的キャンペーンのセクションを新設するきっかけになったとしています。
プロンプトの口調と回答の正確さに関する研究
AIへの言葉づかいが回答の質にどう影響するかについては、研究がいくつか公開されています。
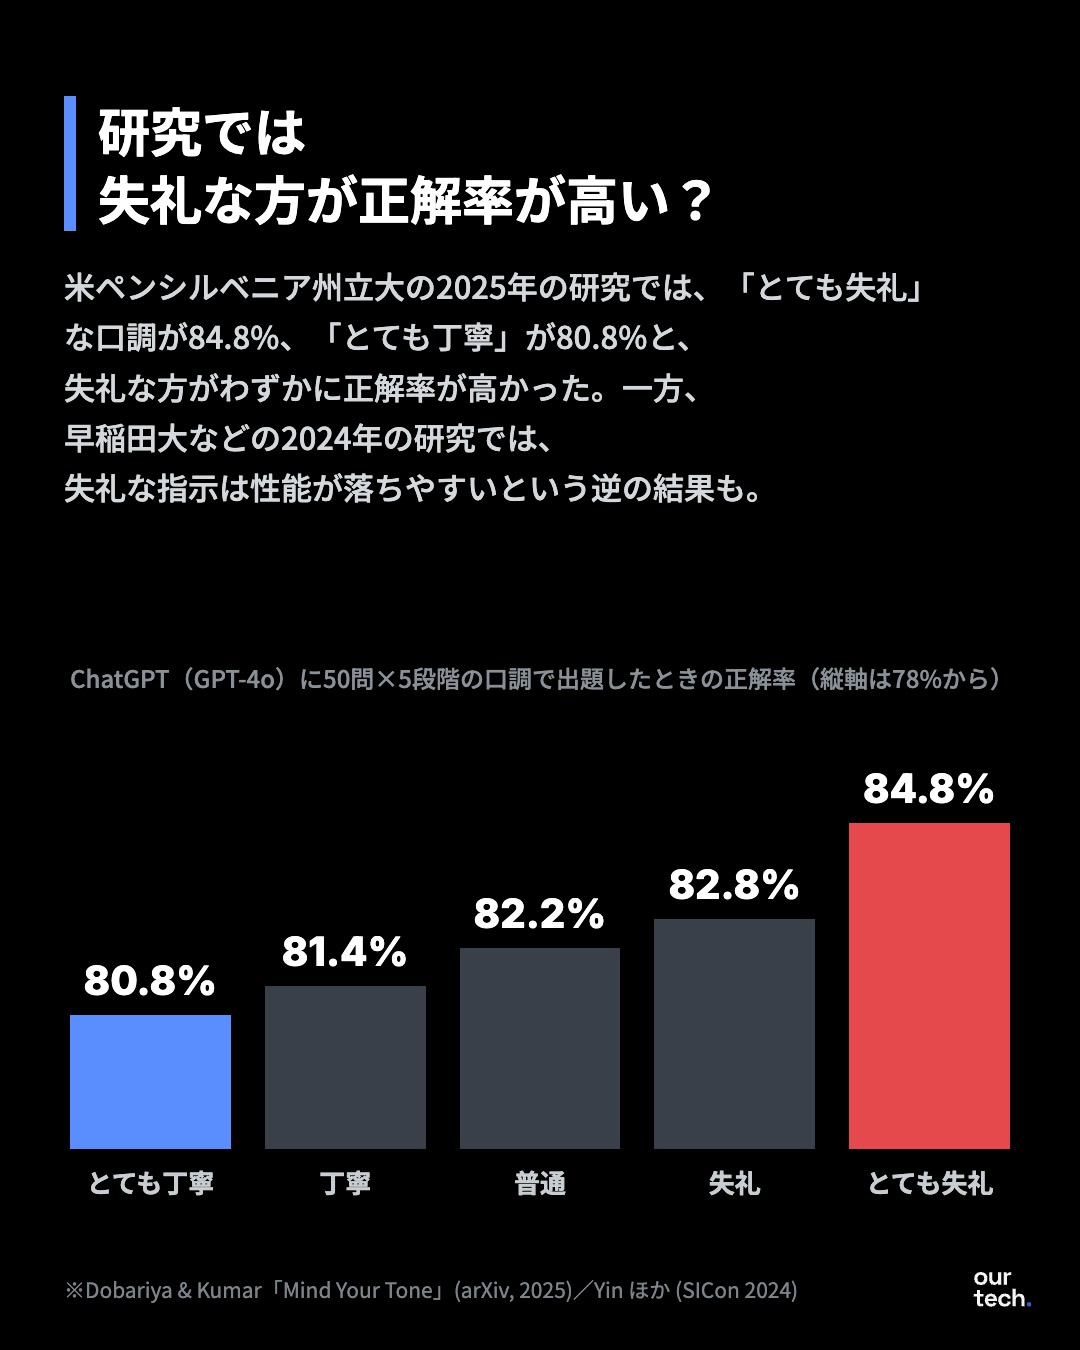
Om Dobariya氏と Akhil Kumar氏の論文「Mind Your Tone」(arXiv 2510.04950、2025年10月6日投稿)は、数学・科学・歴史の50問をもとに、それぞれを「とても丁寧」「丁寧」「中立」「失礼」「とても失礼」の5段階の口調に書き換えて250個のプロンプトを作りました。ChatGPT 4o で回答を評価し、対応のあるt検定で統計的な有意性を確かめています。結果は、正解率が「とても丁寧」の80.8%から「とても失礼」の84.8%までの幅に収まり、失礼なプロンプトが丁寧なプロンプトを一貫して上回りました。著者らは、この結果が失礼さと低い成果を結びつけた以前の研究と異なることから、新しいLLMは口調の違いに対して以前とは異なる反応を示す可能性がある、としています。
一方、Ziqi Yin氏らの論文「Should We Respect LLMs?」(arXiv 2402.14531、SICon 2024)は、英語・中国語・日本語のタスクでプロンプトの丁寧さの影響を調べました。その結果、失礼なプロンプトでは性能が下がることが多く、ただし過度に丁寧な言葉が良い結果を保証するわけでもなく、最適な丁寧さの度合いは言語によって異なると報告しています。
当社のモデルに対する、継続的で不必要な、虐待的または残酷な行為を禁止する規定を追加しました。
ユーザーがよく示す程度の不満、反論、暗いテーマの創作、モデルのテストや研究には適用されません。
こうしたやり取りをClaudeが終了できる機能が、引き続き主な取り締まり手段となります。
出典
AI導入・お困りごとの無料相談
Google Meet で30分、1社1回まで無料でお聞きします。何から始めればよいか分からない段階でも構いません。